m eleições presidenciais realizadas desde 2002, pesquisas do Datafolha divulgadas às vésperas do primeiro turno subestimaram a votação do principal adversário do PT. A recorrência reacende a discussão sobre a confiabilidade das pesquisas, mas estudos mostram que sua acurácia não diminuiu sistematicamente nas últimas décadas. O problema está menos em exigir que os números antecipem o resultado das urnas e mais em compreender o que a margem de erro efetivamente consegue medir.
Por Felipe Schwarzer Paz e Nilton Garcia Sainz
No sábado anterior ao primeiro turno de 2026, cinco dos seis principais institutos de pesquisa apontavam Lula numericamente à frente de Flávio Bolsonaro, quase sempre dentro da margem de erro. No domingo, Flávio terminou com 47,03% dos votos válidos, contra 45,16% de Lula. A cena não é nova. Em 2014, por exemplo, o Datafolha atribuía 26% dos votos válidos a Aécio Neves na véspera do primeiro turno, e ele obteve 33,55%. Em 2018, Ibope e Datafolha davam a Jair Bolsonaro cerca de 41% dos válidos na véspera, e ele obteve 46,03%. Em 2022, a última pesquisa da Quaest antes do primeiro turno registrava 33,5% para Bolsonaro, que recebeu 43,20% dos votos válidos (Pereira; Nunes, 2024).
Fora do Brasil, os exemplos também se acumulam: a vitória de Donald Trump em 2016, o Brexit, a eleição britânica de 2015. A cada episódio, ressurgem questionamentos sobre a acurácia das pesquisas de opinião e propostas de restrição à sua divulgação. Em 2006, foi aprovada a Lei nº 11.300/2006, uma minirreforma eleitoral que visava, entre outras coisas, à restrição da divulgação de pesquisas até 15 dias antes das eleições.[1] Em julho de 2026, o Tribunal Superior Eleitoral (TSE) propôs um “selo de acurácia” para reconhecer institutos cujas estimativas se aproximassem do resultado oficial.[2]
Há razões compreensíveis para a desconfiança. Em meio a novas dinâmicas das redes sociais e a diferentes padrões de abstenção, cresce o número de pesquisas de opinião divulgadas, com metodologias distintas. Entrevistas por telefone, com robôs ou pela internet, mais baratas de realizar, tornam-se cada vez mais comuns e competem com a tradicional entrevista face a face. Somam-se a elas os agregadores de pesquisas, que combinam essas diferentes metodologias e resultados nem sempre convergentes.
Mas parte da desconfiança pode nascer de um mal-entendido: esperar de uma pesquisa eleitoral uma previsão certeira. Uma pesquisa não diz necessariamente quem vai ganhar. Ela mostra, com um grau declarado de incerteza, uma fotografia de como as preferências estavam distribuídas no momento da coleta. Essa incerteza, porém, não se resume à margem de erro divulgada, pois também envolve características da amostra, dos procedimentos de coleta e do próprio comportamento dos eleitores.
Uma colher de sopa
Para saber se a sopa está salgada, ninguém precisa tomar a panela inteira: basta uma colher, desde que a sopa tenha sido bem mexida. A pesquisa eleitoral segue uma lógica semelhante. Com algumas centenas ou milhares de entrevistas, é possível estimar a preferência de mais de 150 milhões de eleitores, desde que a seleção dos entrevistados reflita adequadamente a diversidade do eleitorado. O problema é que, diferentemente de uma sopa, o eleitorado não pode ser simplesmente misturado. As preferências políticas variam entre grupos sociais, regiões e perfis de eleitores. Por isso, não basta entrevistar muitas pessoas. É preciso considerar quem foi entrevistado. Esse “mexer bem”, em uma amostragem probabilística, significa que cada eleitor tenha uma probabilidade conhecida e maior que zero de ser selecionado.
No Brasil, os institutos costumam sortear municípios, depois bairros ou setores censitários e, por fim, preencher cotas de sexo, idade, escolaridade e renda com base em dados do IBGE e do TSE (Meireles; Russo, 2022). Essa última etapa não é necessariamente aleatória, pois, em pesquisas por cotas, o entrevistador seleciona indivíduos até completar os perfis estabelecidos. Por isso, muitas pesquisas brasileiras não são plenamente probabilísticas, isto é, nem todas as etapas de seleção são realizadas por sorteio. Ainda assim, levantamentos que utilizam cotas apresentam desempenho comparável ao de pesquisas inteiramente probabilísticas, em função dos procedimentos de seleção e dos ajustes estatísticos empregados (El-Dash, 2010).
Como se calcula a margem de erro
O acaso do sorteio produz uma incerteza que pode ser calculada. Imagine que a mesma pesquisa, com o mesmo método, fosse repetida milhares de vezes, cada uma com uma amostra diferente. Os resultados não seriam idênticos. Na Figura 1, buscamos demonstrar que sob determinadas condições, as estimativas se distribuiriam em torno do verdadeiro percentual de intenção de voto da população, formando aproximadamente uma curva em forma de sino, conhecida como distribuição normal. A dispersão dessas estimativas é o que a estatística chama de erro padrão.
Efeito do tamanho da amostra sobre a distribuição das estimativas de intenção de voto
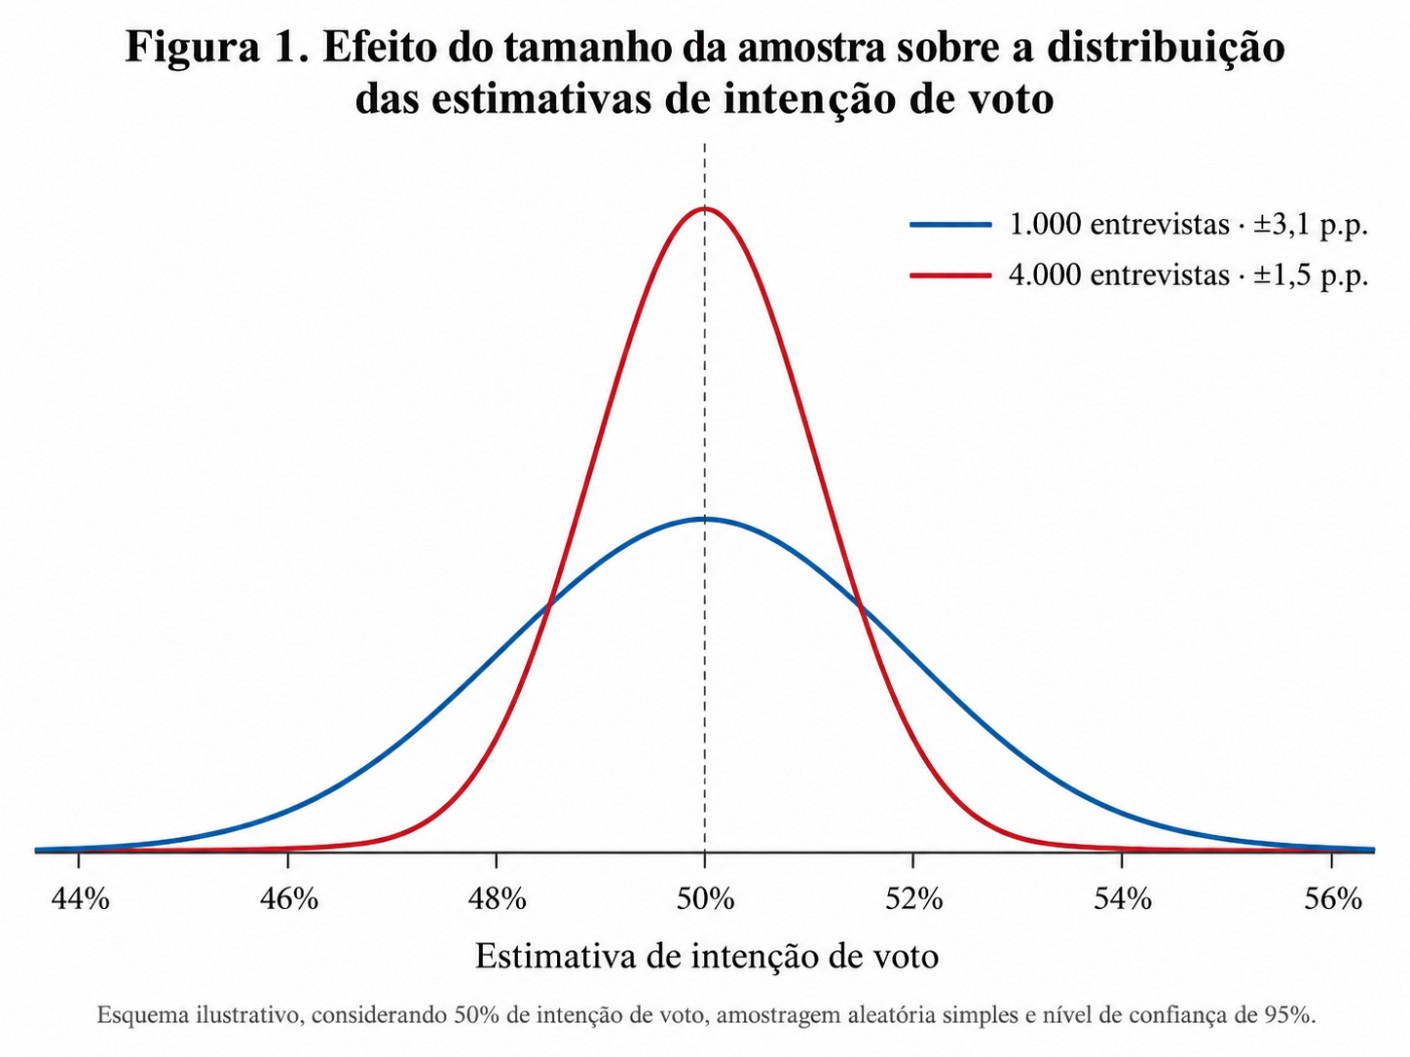
Para uma proporção, como a intenção de voto em um candidato, o cálculo da margem de erro depende principalmente de dois fatores: o percentual estimado para o candidato e o número de entrevistas. Na amostragem aleatória simples, a margem diminui conforme aumenta o tamanho da amostra e atinge seu valor máximo quando a intenção de voto está próxima de 50%. Para mil entrevistas e um candidato com 50% das intenções de voto, a margem é de cerca de 3,1 pontos percentuais, considerando um nível de confiança de 95%.
A fórmula esconde três consequências pouco conhecidas. A primeira é que a margem depende do tamanho da amostra pela raiz quadrada. Para reduzir a margem pela metade, é preciso quadruplicar o número de entrevistas, o que encarece a busca por maior precisão e pode dificultar a realização de pesquisas com amostras muito grandes. A segunda é que a margem muda conforme o percentual do candidato. Os conhecidos “±3 pontos” divulgados pelos institutos correspondem aproximadamente à maior margem esperada em uma amostra aleatória simples de mil entrevistas, quando a proporção estimada está próxima de 50%. Para percentuais menores, a margem absoluta diminui, como sintetizado no quadro a seguir.
Margem de erro em pontos percentuais, com 95% de confiança e amostragem aleatória simples.
Entrevistas |
Candidato com 50% |
Candidato com 30% |
Candidato com 10% |
Candidato com 2% |
450 |
±4,6 |
±4,2 |
±2,8 |
±1,3 |
1.000 |
±3,1 |
±2,8 |
±1,9 |
±0,9 |
2.000 |
±2,2 |
±2,0 |
±1,3 |
±0,6 |
4.000 |
±1,5 |
±1,4 |
±0,9 |
±0,4 |
Fonte: Elaboração própria (2026).
Isso não significa que os candidatos pequenos sejam medidos com maior precisão em todos os sentidos. Um candidato com 2% numa pesquisa de 2 mil entrevistas tem margem aproximada de 0,6 ponto percentual, produzindo um intervalo de confiança de cerca de 1,4% a 2,6%. Embora pequena em pontos percentuais, essa incerteza corresponde a quase um terço do total de votos estimados. Em termos relativos, portanto, o resultado apresenta uma incerteza considerável, o que recomenda cautela na comparação entre candidatos com percentuais muito baixos.
A terceira consequência é a mais importante para quem acompanha a corrida eleitoral. A margem de cada candidato não basta para saber se existe uma diferença estatisticamente distinguível de zero entre eles. Numa amostra aleatória simples de mil pessoas, 34% contra 30% pode parecer uma liderança clara. Entretanto, a margem de erro da diferença entre esses percentuais é de aproximadamente 5 pontos percentuais, considerando um nível de confiança de 95%. Isso ocorre porque as estimativas dos candidatos não são independentes. Quando um entrevistado escolhe um candidato, não escolhe simultaneamente o outro, de modo que é necessário considerar essa relação no cálculo. Assim, a diferença observada de cerca de quatro pontos é compatível tanto com uma vantagem próxima de oito pontos quanto com uma pequena vantagem do segundo colocado. É esse tipo de situação que a imprensa costuma chamar de “empate técnico”, embora a avaliação adequada dependa da incerteza associada à diferença entre os candidatos.
O “nível de confiança de 95%” também costuma ser mal interpretado. Ele não significa que haja 95% de probabilidade de o verdadeiro percentual estar dentro do intervalo de uma pesquisa específica. Na interpretação estatística frequentista, significa que, se a mesma pesquisa fosse repetida muitas vezes, com o mesmo procedimento e amostras diferentes, cerca de 95% dos intervalos obtidos conteriam o verdadeiro percentual de intenção de voto da população. Em outras palavras, de cada vinte pesquisas idênticas, espera-se que uma traga um intervalo que não contém esse valor, apenas por variabilidade amostral, mesmo com o procedimento corretamente aplicado. Numa eleição com centenas de pesquisas registradas, alguns intervalos que deixam de conter o valor verdadeiro seriam esperados mesmo sob condições ideais de amostragem.
Por fim, toda essa conta pressupõe uma amostragem aleatória simples, mas as pesquisas brasileiras frequentemente utilizam desenhos mais complexos. Quando se sorteiam bairros e depois se entrevistam vizinhos, por exemplo, as respostas podem ser mais semelhantes entre si do que num sorteio distribuído por todo o país. Nesse caso, cada entrevista adicional pode trazer menos informação nova. Estatísticos chamam a relação entre a variância produzida por um desenho amostral e aquela esperada sob amostragem aleatória simples de efeito do desenho amostral. Se esse efeito for igual a dois, por exemplo, uma pesquisa de 2 mil entrevistas terá aproximadamente a mesma precisão amostral de uma pesquisa de mil entrevistas sob sorteio simples. A margem de erro, nesse exemplo, aumenta de aproximadamente 2,2 para 3,1 pontos percentuais.
Um episódio famoso nesse sentido ocorreu em 1936, quando a revista americana Literary Digest reuniu mais de dois milhões de respostas e, mesmo assim, indicou incorretamente o vencedor da eleição presidencial. A enorme quantidade de respostas não impediu o erro porque os participantes não representavam adequadamente o eleitorado americano, com presença desproporcional de grupos socialmente mais favorecidos. O episódio demonstra que aumentar o número de entrevistas reduz a incerteza produzida pelo acaso, mas não corrige, por si só, os problemas de representatividade da amostra.
No Brasil, a legislação exige que os institutos registrem informações metodológicas das pesquisas na Justiça Eleitoral já no início do ano eleitoral, incluindo a margem de erro e o nível de confiança. Entretanto, a margem informada não necessariamente incorpora todos os efeitos do desenho amostral, realizados posteriormente, nem os possíveis erros relacionados à seleção e à participação dos entrevistados. Por isso, interpretar a precisão de uma pesquisa exige considerar também os procedimentos efetivamente empregados em sua realização.
Quando muitas pesquisas viram uma
A mesma lógica explica o apelo dos agregadores, que ganham popularidade por fazerem um balanço de diversas pesquisas, o que tende a gerar erros tanto de interpretação como de apresentação dos dados.
Primeiramente, ao suavizar as mudanças captadas, as médias transmitem uma estabilidade que a opinião pública não tem. Pesquisas discrepantes, frequentemente descartadas como “pontos fora da curva”, também são sinais da incerteza real da medição. Na conclusão de Christopher Prosser e Jonathan Mellon, que revisaram os erros de pesquisas em diversos países, médias e previsões “podem dar uma imagem de estabilidade e certeza da opinião pública que não se justifica”.
Além disso, se o único erro fosse o do sorteio, juntar dez pesquisas de mil entrevistas equivaleria a uma pesquisa de dez mil, com margem de cerca de 1 ponto, e o volume crescente de pesquisas traria cada vez mais certeza. Mas a média só cancela erros que apontam para lados diferentes. Erros que empurram todas as pesquisas na mesma direção, como os que veremos adiante, não se anulam: o valor indicado apenas soma os vieses das pesquisas. Em 2026, como quase todos os institutos subestimaram Flávio Bolsonaro, qualquer média entre eles também o faria.
Quanto as pesquisas realmente erram
A percepção de que a precisão das pesquisas piorou não encontra respaldo nas evidências históricas. Will Jennings e Christopher Wlezien (2018) reuniram mais de 30 mil pesquisas de 351 eleições em 45 países, de 1942 a 2017. Na semana final das campanhas, o erro absoluto médio foi de aproximadamente 2,1 pontos percentuais por candidato, valor semelhante ao encontrado desde os anos 1940. As eleições recentes que ficaram famosas pelos erros não fugiram necessariamente do padrão histórico. Se algo mudou, os resultados sugerem uma leve diminuição do erro ao longo do tempo.
O Brasil apresenta resultados comparáveis. Analisando mais de 2 mil pesquisas de 2012 a 2020, Fernando Meireles e Guilherme Russo (2022) encontraram um erro médio de 1,8 ponto percentual nas pesquisas de véspera. A diferença em relação ao resultado eleitoral aumenta quanto maior a distância entre a pesquisa e o dia da votação. Quinze dias antes, o erro médio foi de 3,8 pontos, enquanto três dias antes foi de 2,9 pontos percentuais. Por isso, é importante lembrar que pesquisas são retratos de um momento da corrida eleitoral, e não necessariamente ferramentas de previsão dos resultados das urnas.
Há, porém, um descompasso. Embora o erro médio seja relativamente pequeno, a dispersão das diferenças observadas é maior do que as margens de erro habitualmente divulgadas sugerem. Em 2010, apenas 47% das pesquisas para presidente e governador apresentaram um erro agregado dentro da margem informada, com discrepâncias especialmente elevadas nas disputas para governador (Gramacho, 2013). Meireles e Russo (2022) calcularam que a variação dos erros observados nas pesquisas brasileiras corresponde a uma margem equivalente de cerca de 6,8 pontos percentuais, acima dos dois ou três pontos convencionalmente divulgados, mas comparável à encontrada em outras democracias.
Parte desse descompasso pode estar relacionada aos efeitos do desenho amostral, nem sempre incorporados às margens anunciadas. Há também uma diferença fundamental entre a incerteza amostral, estimada no momento da pesquisa, e a distância posteriormente observada em relação ao resultado das urnas. Nas palavras de Meireles e Russo (2022), “o problema reside mais nas margens de erro, e menos nas estimativas”. A outra parte da explicação é mais interessante: há erros que a margem de erro convencional não pretende medir.
O que a margem de erro não vê
O alerta é antigo. Em 1944, o estatístico W. Edwards Deming listou 13 fatores que comprometem um levantamento e advertiu que o erro de amostragem era apenas um deles (Groves; Lyberg, 2010). A metodologia de surveys passou a chamar o conjunto dessas fontes de incerteza de “erro total”. Além do acaso do sorteio, há quem não seja alcançado, quem se recusa a responder, perguntas mal formuladas, efeitos do entrevistador e falhas no processamento. A diferença decisiva é que a margem de erro convencional procura expressar a incerteza associada à amostragem, enquanto os demais problemas podem introduzir tanto variações aleatórias quanto distorções sistemáticas. Essas últimas não desaparecem necessariamente com o aumento do número de entrevistas e podem até se reforçar quando diferentes pesquisas apresentam problemas semelhantes, e pode amplificar o erro de agregadores.
Um dos problemas mais recorrentes, em diversos países, é a amostra que não representa bem o eleitorado. A queda nas taxas de resposta não é, por si só, um problema. Se quem não responde tem as mesmas preferências de quem responde, a estimativa não muda por esse motivo. O problema surge quando a recusa se concentra em determinados perfis de eleitores.
Os institutos procuram corrigir desequilíbrios demográficos com ponderação, dando mais peso aos entrevistados de grupos sub-representados, mas o ajuste depende de bons dados sobre a população e das características consideradas. No Brasil, o censo demográfico, previsto para ocorrer a cada dez anos, sofreu um atraso durante a pandemia, o que levou os institutos a continuar utilizando dados de 2010, complementados pela Pesquisa Nacional por Amostra de Domicílios Contínua (PNAD Contínua), até a divulgação dos resultados do Censo de 2022. Mesmo assim, a ponderação não elimina necessariamente os problemas de não resposta. Eleitores com características demográficas semelhantes podem apresentar preferências políticas distintas e probabilidades diferentes de participar de uma pesquisa, especialmente quando há desconfiança em relação aos institutos ou à imprensa.
O modo de coleta acrescenta outra camada. Cada modo alcança um público diferente. A entrevista presencial enfrenta dificuldades para entrar em condomínios com controle de acesso e em áreas controladas pelo crime organizado; a telefônica depende de quem atende ligações de números desconhecidos; a online alcança apenas quem tem acesso à internet e aceita participar da pesquisa. A presença do entrevistador também pesa: em determinadas circunstâncias, modos mais impessoais podem facilitar a declaração de respostas que o entrevistado considera socialmente malvistas.
O resultado são diferenças entre os levantamentos que podem persistir mesmo depois da ponderação. Em julho de 2022, as pesquisas telefônicas mostravam uma vantagem de Lula sobre Bolsonaro 4,8 pontos percentuais menor que as presenciais (El-Dash, 2022). Naquele primeiro turno, Lula venceu por cerca de cinco pontos, resultado mais próximo do que indicavam as pesquisas telefônicas. Entretanto, a proximidade com as urnas não permite determinar, isoladamente, qual modo de entrevista mediu melhor a opinião pública no momento da coleta, e a comparação com eleições anteriores não sustenta que um deles seja sistematicamente mais preciso.
Esse possível efeito da presença do entrevistador está relacionado ao chamado viés de desejabilidade social, que ocorre quando uma pessoa modifica sua resposta por receio de julgamento ou reprovação. Nas pesquisas eleitorais, uma de suas manifestações possíveis é o “voto envergonhado”, hipótese frequentemente mobilizada para explicar a subestimação de candidatos controversos. Entretanto, sua importância empírica permanece em debate. Estudos sobre a eleição norte-americana de 2016 encontraram poucas evidências de que eleitores ocultassem sistematicamente seu apoio a Donald Trump (Coppock, 2017; Kennedy et al., 2018). Isso não elimina a possibilidade de desejabilidade social em outros contextos, mas mostra que sua existência não pode ser presumida apenas pela diferença entre pesquisas e resultados eleitorais.
Há ainda as escolhas do pesquisador. É preciso estimar quem de fato vai votar. Mesmo com voto obrigatório, a abstenção existe e não é igual entre grupos sociais. Quando uma pesquisa inclui eleitores que não comparecerão às urnas, pode superestimar candidatos apoiados por grupos com maior propensão à abstenção, caso essa diferença não seja adequadamente considerada. E há os indecisos. Ao excluí-los do cálculo das intenções de voto válidas, os institutos recalculam os percentuais considerando apenas os eleitores que declararam uma preferência. Esse procedimento equivale matematicamente a uma redistribuição proporcional das respostas, mas não garante que os indecisos se comportarão da mesma maneira no dia da eleição.
Uma segunda família de explicações não está necessariamente na pesquisa, mas nas mudanças do próprio eleitorado. A última pesquisa é realizada antes da votação, e as preferências podem mudar nesse intervalo. Essa explicação é impopular, porque pode soar como desculpa dos institutos, mas tem respaldo na literatura. Uma pesquisa pode retratar adequadamente a opinião pública no momento da coleta e, ainda assim, apresentar números diferentes dos observados nas urnas, caso uma parcela dos eleitores mude de preferência posteriormente.
No Brasil, Frederico Batista Pereira e Felipe Nunes (2024) apontam dois mecanismos. O primeiro é o “voto útil”, uma forma de voto estratégico em que eleitores de candidatos com poucas chances de vitória migram para um dos favoritos, buscando evitar a eleição do adversário que mais rejeitam. Na véspera do primeiro turno de 2022, metade dos eleitores da chamada terceira via dizia que ainda poderia mudar o voto. As pesquisas atribuíam 11,6% aos demais candidatos, que receberam cerca de 8% dos votos válidos nas urnas. O segundo mecanismo é o alinhamento tardio dos indecisos, que pode ser influenciado por campanhas em aplicativos de mensagem e por redes de influência social, como as igrejas evangélicas. A divergência entre pesquisas e resultados diminuiu expressivamente no segundo turno, sem que os institutos necessariamente tivessem alterado seus métodos, resultado compatível com a importância das mudanças de preferência durante a campanha.
Os autores também identificam diferenças na magnitude das discrepâncias entre contextos eleitorais, associadas à presença de eleitores indecisos, à desigualdade de recursos entre campanhas e à menor visibilidade de determinadas disputas, como as eleições para o Senado. Essas associações podem estar relacionadas a decisões de última hora e à influência de estratégias de campanha, mas não demonstram, isoladamente, que esses mecanismos sejam responsáveis pelas diferenças observadas. O ponto central é que mudanças nas preferências entre a realização da pesquisa e a votação não são erros de amostragem. Se os eleitores de um grupo mudam de ideia na véspera, dar mais peso a esse grupo não necessariamente aproxima a estimativa anterior ao resultado final.
O tipo de eleição também pode influenciar a magnitude das discrepâncias. Estudos comparativos identificam diferenças no desempenho das pesquisas conforme as características das disputas eleitorais e dos sistemas partidários (Jennings; Wlezien, 2018). No Brasil, fatores como o número de candidaturas, o grau de identificação partidária, o voto obrigatório e as decisões tardias podem tornar mais complexa a comparação entre pesquisas e resultados eleitorais (Lloyd; Turgeon, 2021). A direção dos erros, por sua vez, não é necessariamente fixa. Gramacho (2013), ao examinar um conjunto de pesquisas presidenciais e estaduais de 2010, identificou maior frequência de subestimação de candidaturas de esquerda, enquanto, em eleições presidenciais recentes, observamos episódios expressivos de subestimação de candidatos à direita. Isso não significa que exista uma direção universal para os erros, mas que sua interpretação depende do período, dos institutos, das eleições e dos candidatos analisados.
Ler pesquisas como probabilidades
Os institutos não estão parados. As amostras nacionais cresceram: as últimas pesquisas de 2026 ouviram entre 2 mi e quase 5 mil pessoas. Modelos que estimam o “eleitor provável” começam a ser usados no Brasil. O fato de o erro médio não ter aumentado, apesar da queda das taxas de resposta e da multiplicação de métodos, sugere que os institutos têm conseguido lidar com parte desses desafios, embora não seja possível atribuir esse resultado a uma única adaptação metodológica. Outras melhorias dependem de transparência: divulgar margens de erro que considerem, quando aplicável, os efeitos do desenho amostral e informar as demais fontes de incerteza; mostrar os indecisos em vez de redistribuí-los silenciosamente; informar a margem da diferença entre os primeiros colocados; e, como propõem Pereira e Nunes (2024), medir a propensão de cada eleitor a mudar de voto para oferecer cenários, e não um número único.
É nessa chave que iniciativas como o selo proposto pelo TSE merecem cautela. Julgar um instituto exclusivamente pela distância entre uma pesquisa e o resultado final é como julgar um meteorologista pela chuva de um único dia: se a previsão era de 70% de chance de chuva e o dia amanheceu seco, ele não necessariamente errou. Só ao longo de muitos dias se sabe se os seus 70% significam, de fato, chuva em sete de cada dez. A comparação tem um limite: enquanto a previsão meteorológica atribui probabilidades a acontecimentos futuros, a pesquisa eleitoral procura estimar preferências existentes no momento da entrevista.
A Associação Brasileira de Empresas de Pesquisa (Abep) argumenta que pesquisas captam a intenção de voto num momento e não são prognósticos. Com voto útil e decisões tardias, uma pesquisa feita sete dias antes pode ter medido bem o eleitorado daquele dia e ainda assim “errar” o domingo. Um selo baseado exclusivamente na proximidade com os resultados das urnas pode estimular institutos a privilegiar a antecipação do resultado eleitoral em vez da mensuração das preferências no momento da coleta. Além disso, deixaria de considerar outras dimensões importantes da qualidade das pesquisas, como a construção da amostra, o treinamento dos entrevistadores, os procedimentos de coleta e o tratamento estatístico dos dados.
Deming escreveu, em 1944, que a precisão exigida de um levantamento costuma ser exagerada e muitas vezes inalcançável, mas que um survey bem feito continua útil como base racional para decidir (Groves; Lyberg, 2010). A frase serve para as pesquisas eleitorais. Elas não anunciam o futuro; procuram descrever um eleitorado em movimento, com uma parte da incerteza estatisticamente mensurável e outras fontes de erro que nem sempre podem ser quantificadas. Ler uma pesquisa como uma estimativa sujeita a diferentes fontes de incerteza, e não como um placar definitivo, é o primeiro passo para compreender seus limites e reconhecer sua contribuição ao conhecimento da opinião pública.
Felipe Schwarzer Paz é mestrando em ciência política no Programa de Pós-Graduação em Ciência Política da Universidade Federal do Paraná (UFPR).
Nilton Sainz é doutor em ciência política pela Universidade Federal do Paraná (UFPR), onde atua como professor do Departamento de Ciência Política e Programa de Pós-Graduação em Ciência Política.
Referências
El-Dash, N. A. Avaliação metodológica das pesquisas eleitorais brasileiras. Tese (Doutorado em Estatística) — Instituto de Matemática e Estatística, Universidade de São Paulo, São Paulo, 2010.
El-Dash, N. A. Qual modo de pesquisa melhor mede a opinião pública: telefônica ou presencial? PollingData, 30 jul. 2022. Disponível em: https://www.pollingdata.com.br/2022/07/qual-tipo-de-pesquisa-mede-melhor-a-opiniao-public a-brasileira-telefonica-ou-presencial/.
Gramacho, W. G. “À margem das margens? A precisão das pesquisas pré-eleitorais brasileiras em 2010”. Opinião Pública, Campinas, v. 19, n. 1, p. 65–80, jun. 2013.
Groves, R. M.; Lyberg, L. “Total survey error: past, present, and future”. Public Opinion Quarterly, v. 74, n. 5, p. 849–879, 2010.
Jennings, W; Wlezien, C. “Election polling errors across time and space”. Nature Human Behaviour, v. 2, n. 4, p. 276–283, 2018.
Lloyd, R; Turgeon, M. “Polling in new democracies and electoral malpractice: the case of Brazil”. International Journal of Public Opinion Research, v. 33, n. 4, p. 1039–1049, 2021.
Meireles, F; Russo, G. “Pesquisas eleitorais no Brasil: tendências e desempenho”. Estudos Avançados, São Paulo, v. 36, n. 106, p. 117–131, 2022.
Pereira, F. B; Nunes, F. “Pesquisas eleitorais e mudanças tardias na decisão do voto”. Opinião Pública, Campinas, v. 30, e3011, 2024.
Prosser, C; Mellon, J. “The twilight of the polls? A review of trends in polling accuracy and the causes of polling misses”. Government and Opposition, v. 53, n. 4, p. 757–790, 2018.
Notas
[1] A restrição foi afastada pelo Supremo Tribunal Federal (STF) no julgamento da ADI 3.741/2006.
[2] Agência Brasil, julho de 2026: https://agenciabrasil.ebc.com.br/justica/noticia/2026-07/tse-sugere-selo-para-premiar-institutos-de-pesquisas-eleitorais